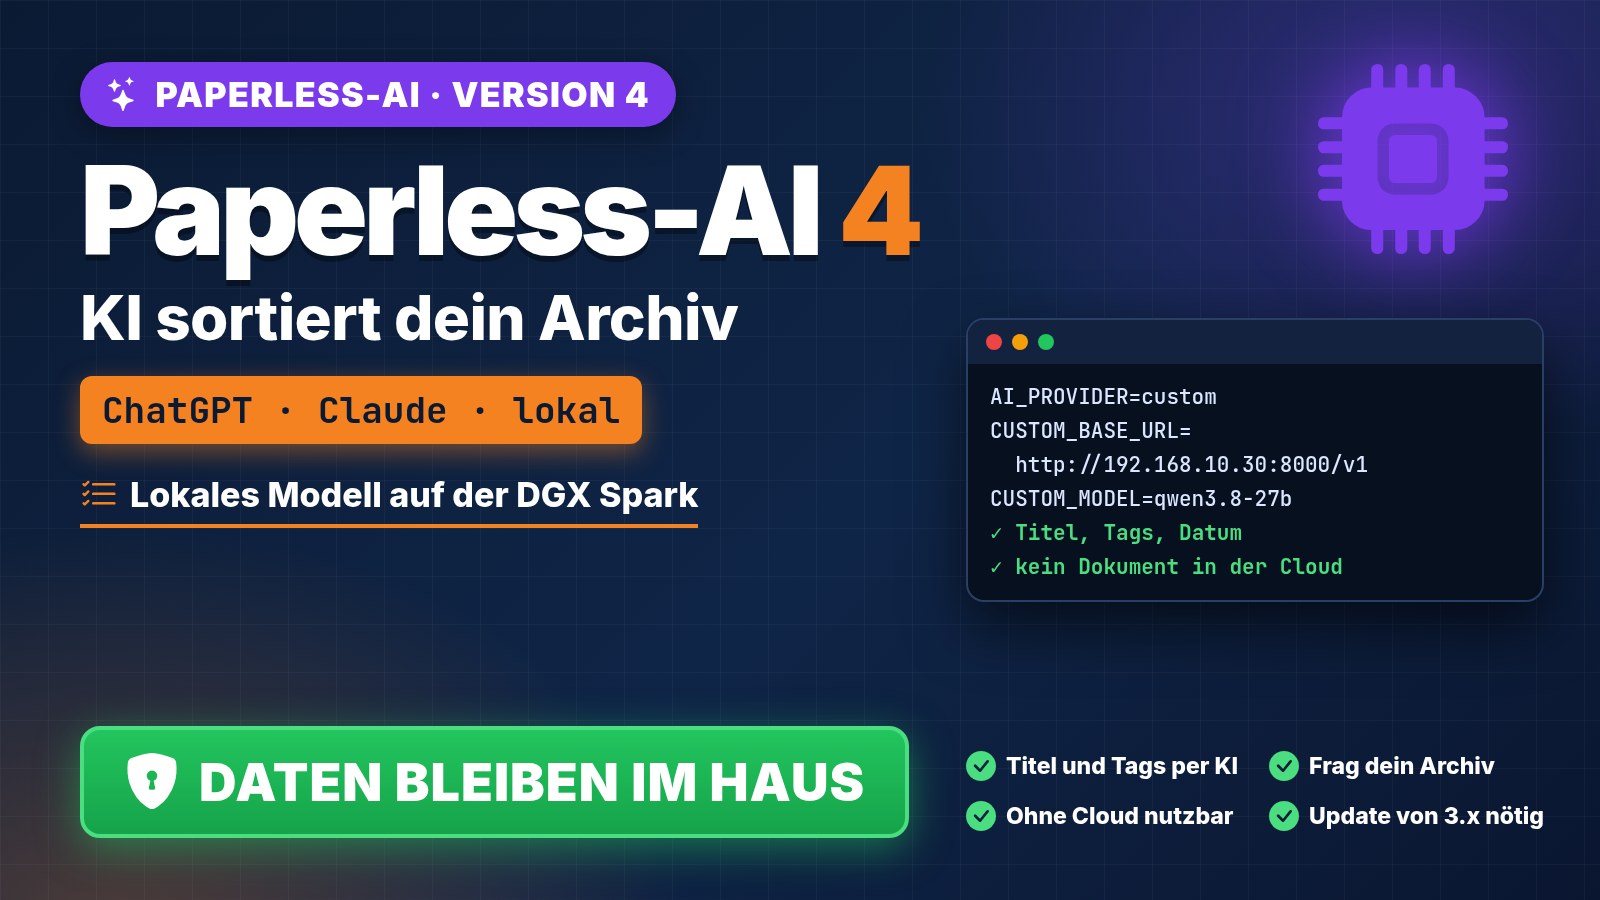
Paperless-ngx sortiert Dokumente, aber benennen, verschlagworten und zuordnen musst du am Anfang selbst. Paperless-AI nimmt dir diese Arbeit ab: Eine KI liest jedes neue Dokument und trägt Titel, Tags, Korrespondent, Dokumenttyp und Datum ein. Mit Version 4 wurde das Projekt komplett neu geschrieben. Wir zeigen dir, was neu ist, wie du ChatGPT oder Claude anbindest und warum wir selbst ein lokales Sprachmodell auf der NVIDIA DGX Spark nutzen.
Bei uns läuft Paperless-AI 4 im Zusammenspiel mit einer DGX Spark im eigenen Rack. Kein Dokument verlässt dabei das Haus. Genau das ist der Punkt, an dem sich die drei Varianten in diesem Beitrag am stärksten unterscheiden.
Dieser Beitrag baut auf unserer Anleitung Paperless-ngx auf dem NAS einrichten auf. Ein laufendes Paperless-ngx setzen wir voraus.
Was ist Paperless-AI?
Paperless-AI ist ein quelloffener Zusatz für Paperless-ngx, veröffentlicht unter der MIT-Lizenz. Das Programm läuft als eigener Container neben dem Archiv, holt sich neue Dokumente über die Schnittstelle von Paperless-ngx, lässt den Text von einem Sprachmodell auswerten und schreibt das Ergebnis zurück. Welches Sprachmodell das ist, entscheidest du: ein Dienst in der Cloud oder ein Modell auf eigener Hardware.
Ehrlich dazu gehört: Paperless-AI ist nach Angabe des Entwicklers ein Hobbyprojekt, und große Teile der Version 4 sind mit Hilfe von KI-Werkzeugen entstanden. Das Projekt empfiehlt selbst, die Anwendung im lokalen Netz zu halten und nicht ungeschützt ins Internet zu stellen.
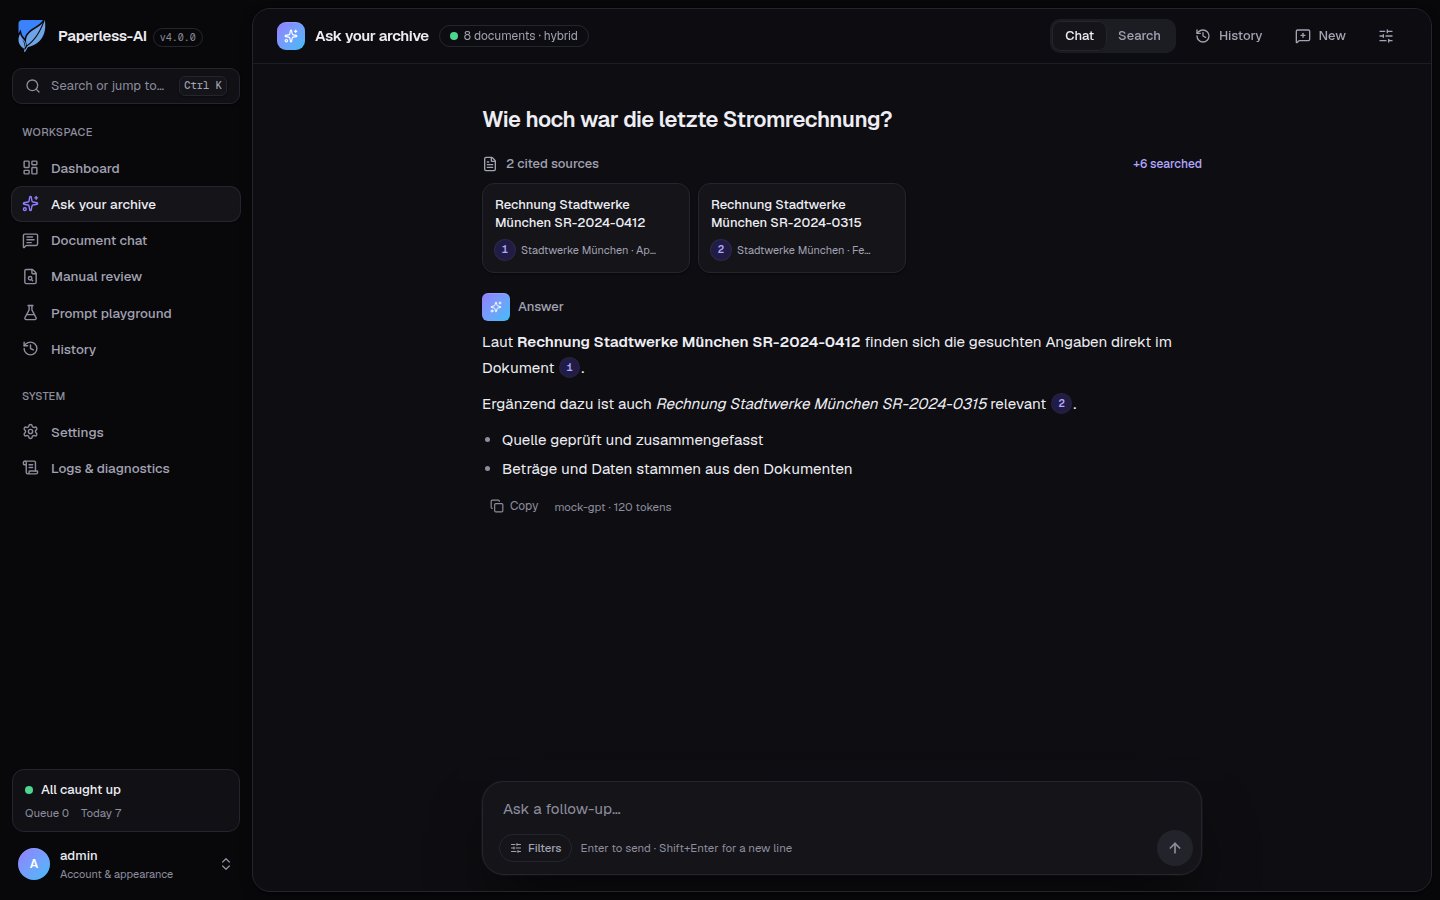
Neuerungen in Version 4
Version 4.0 erschien am 10. November 2026 als vollständige Neuentwicklung. Seitdem folgten in kurzer Folge weitere Ausgaben, zuletzt 4.4.0 am 20. November 2026. Die wichtigsten Neuerungen:
- Ein Prozess statt zwei: Die Anwendung besteht nur noch aus einem Node.js-Prozess. Das Image ist laut Projekt rund 135 MB groß statt mehrerer Gigabyte.
- Mehr Anbieter: OpenAI, Anthropic mit Claude, Ollama, Azure OpenAI und jede Schnittstelle, die das OpenAI-Format spricht, etwa vLLM, LM Studio oder OpenRouter.
- Frag dein Archiv: Fragen in normaler Sprache über alle Dokumente, mit kombinierter Stichwort- und Vektorsuche und Antworten samt Quellenangabe.
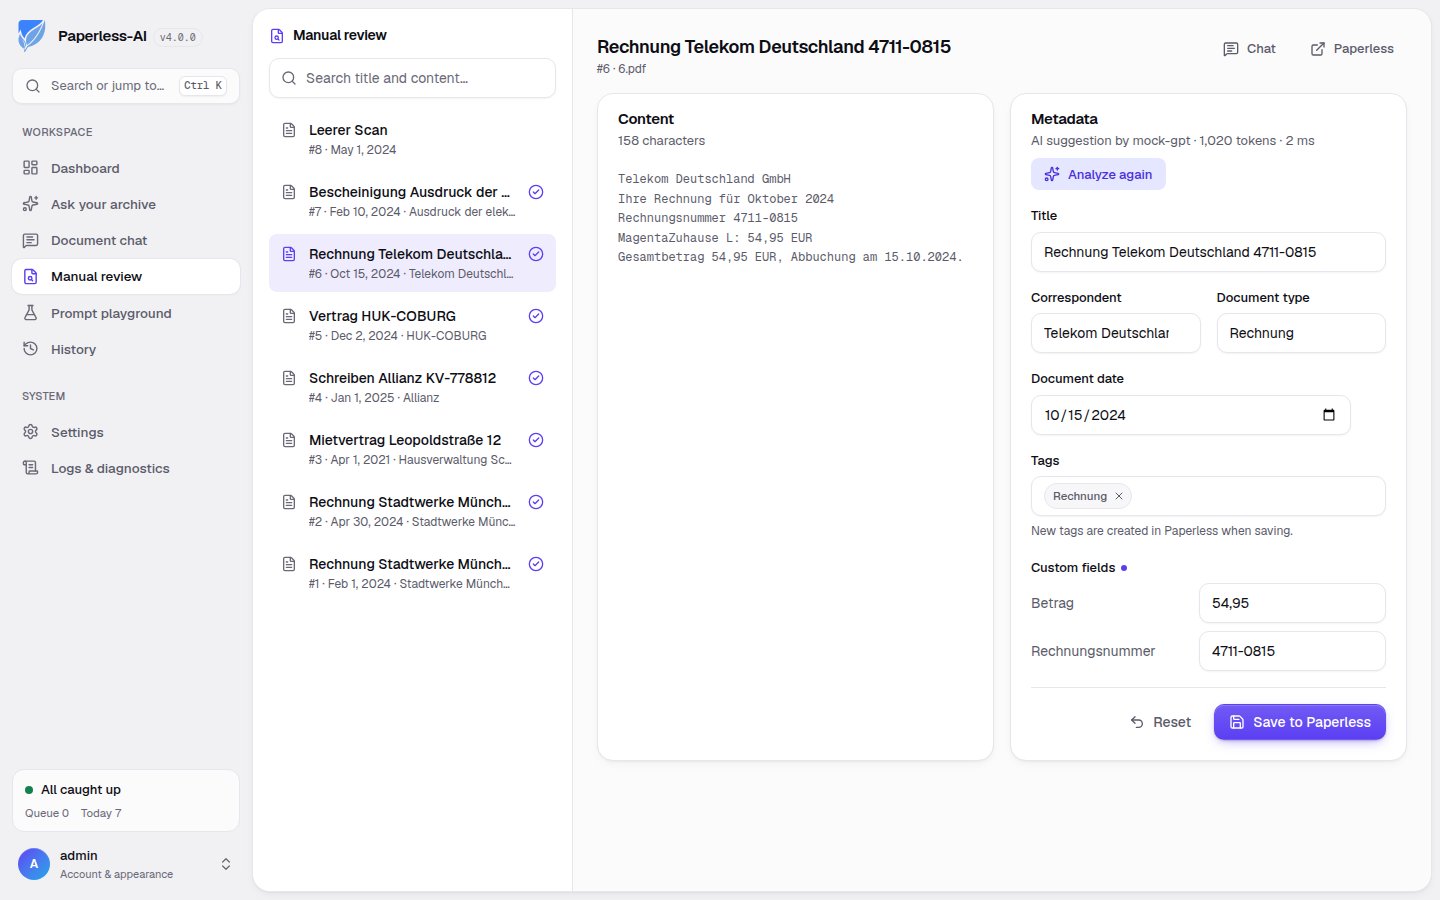
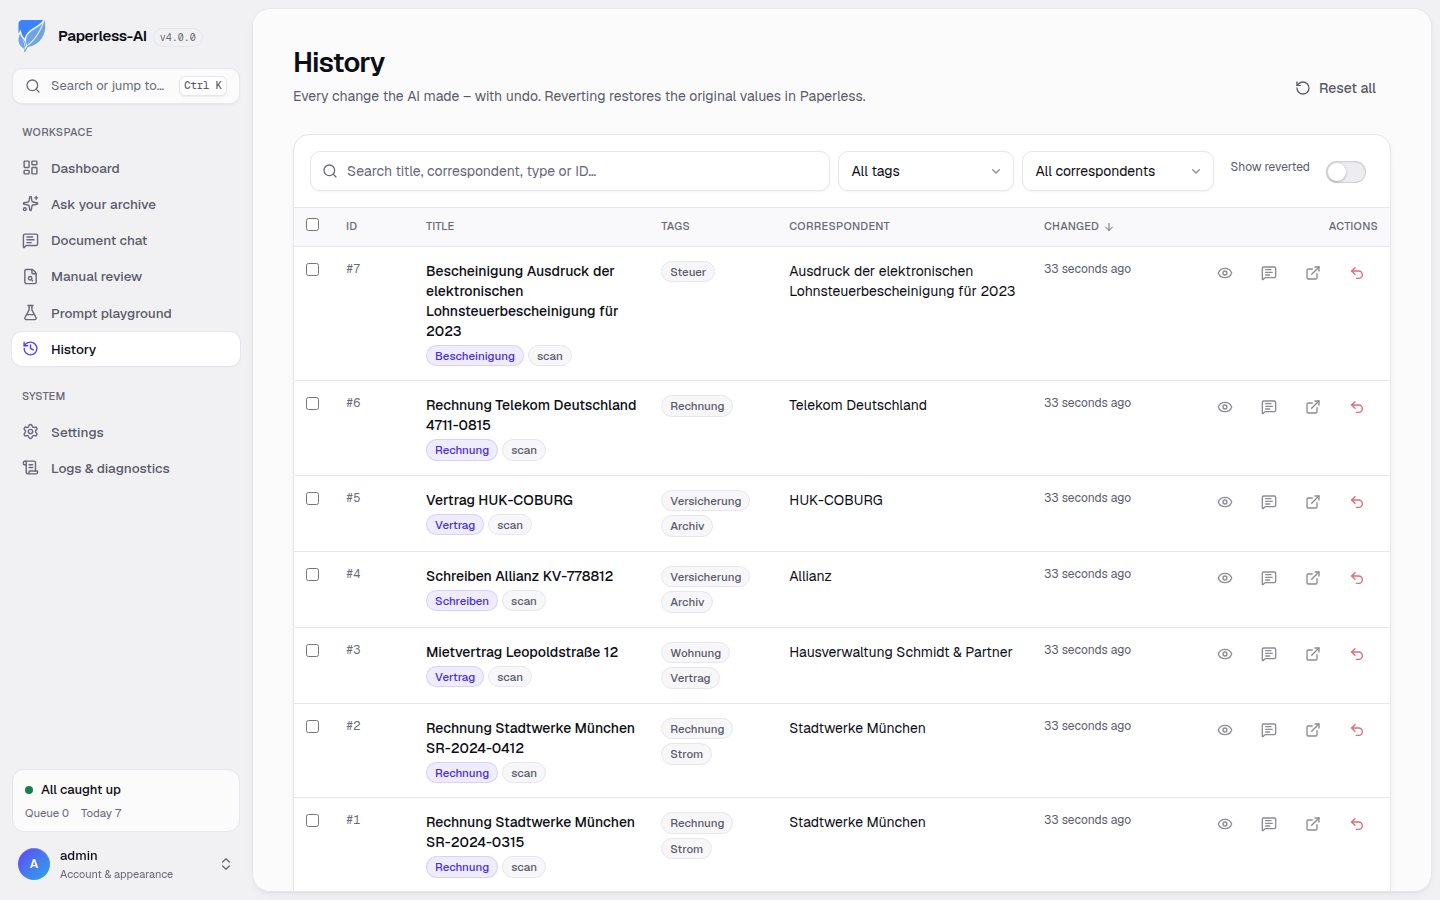
- Verlauf mit Rückgängig: Jede Änderung der KI lässt sich nachvollziehen und zurücknehmen.
- Manuelle Prüfung: Vorschläge der KI ansehen und erst dann nach Paperless-ngx speichern.
- Einstellungen ohne Neustart: Alles wird in der Weboberfläche eingestellt und gilt sofort.
- OCR (seit 4.1): Schlecht lesbare Scans liest Paperless-AI auf Wunsch lokal mit PaddleOCR neu ein, bevor die KI sie auswertet.
- Zwei-Faktor-Authentifizierung (2FA), Prompt-Bibliothek und Kalender (seit 4.2): Anmeldung mit Authenticator-App, geprüfte Prompts je Modell und Fristen aus Dokumenten als Kalender.
- Single Sign-on (seit 4.3): Anmeldung über OpenID Connect, etwa mit Authentik oder Keycloak.
- Prompt-Regeln (seit 4.4): Unterschiedliche Prompts und Einstellungen je Dokumentart, zum Beispiel für Haushaltspapiere und Unterrichtsmaterial im selben Archiv.
LLM-Anbindung: drei Varianten im Vergleich
Paperless-AI schickt den Text jedes Dokuments an ein Sprachmodell. Wo dieses Modell läuft, ist die wichtigste Entscheidung der ganzen Einrichtung.
| Variante | Wo läuft das Modell? | Kosten | Datenschutz |
|---|---|---|---|
| OpenAI | Rechenzentren von OpenAI | je Dokument, gering | Inhalte gehen an einen US-Anbieter |
| Claude | Rechenzentren von Anthropic | je Dokument, gering | Inhalte gehen an einen US-Anbieter |
| Lokales Modell | eigene Hardware im Haus | einmalig Hardware, dazu Strom | Inhalte bleiben im eigenen Netz |
Die Cloud-Varianten sind in zehn Minuten eingerichtet und liefern sehr gute Ergebnisse. Die lokale Variante kostet einmalig Geld und etwas Einrichtung, dafür sieht kein Dritter jemals einen Kontoauszug oder Arztbrief.
Datenschutz: Cloud-API gegenüber lokaler Inferenz
In einem Dokumentenarchiv liegt das Sensibelste, was ein Haushalt oder Betrieb besitzt: Gehaltsabrechnungen, Steuerbescheide, Verträge, Krankenunterlagen, Personalakten, Kundendaten. Paperless-AI überträgt den vollen Text jedes verarbeiteten Dokuments an das Sprachmodell. Bei einem Cloud-Anbieter heißt das:
- Auftragsverarbeitung: Betriebe brauchen mit dem Anbieter einen Vertrag zur Auftragsverarbeitung.
- Drittland: OpenAI und Anthropic sind US-Unternehmen. Die Übermittlung muss rechtlich abgesichert und dokumentiert sein.
- Informationspflichten: Die Verarbeitung gehört ins Verzeichnis der Verarbeitungstätigkeiten und in die Datenschutzhinweise.
- Berufsgeheimnis: Für Arztpraxen, Kanzleien und Steuerbüros gelten zusätzlich strengere Regeln für die Einschaltung externer Dienstleister.
- Vertrauen: Du verlässt dich darauf, dass der Anbieter die Daten so behandelt, wie er es zusagt.
Mit einem lokalen Modell entfällt die Übermittlung an Dritte vollständig. Es gibt keinen weiteren Auftragsverarbeiter, kein Drittland und keinen Schlüssel, der in falsche Hände geraten könnte. Die Dokumente wandern vom Archiv zum Rechner mit dem Sprachmodell und zurück, beides im eigenen Netz. Das ist der Aufbau, mit dem wir selbst arbeiten.
Zwei Einordnungen dazu. Erstens: Lokal heißt nicht automatisch rechtskonform. Zugriffsrechte, Löschfristen und Datensicherung musst du weiterhin sauber regeln. Der schwierigste Teil, die Weitergabe an einen KI-Anbieter, ist aber vom Tisch. Zweitens: Auch der Weg über die Cloud lässt sich rechtlich sauber gestalten. Er macht nur mehr Arbeit und bleibt bei besonders schützenswerten Daten eine Abwägung. Im Zweifel hilft dein Datenschutzbeauftragter.
Installation von Paperless-AI 4
1. Eigenen Benutzer in Paperless-ngx anlegen
Lege in Paperless-ngx einen eigenen Benutzer für Paperless-AI an. Er braucht die Rechte, Dokumente, Tags, Korrespondenten, Dokumenttypen und eigene Felder anzusehen und zu ändern. Melde dich mit diesem Benutzer an und erzeuge im Profil ein API-Token. Paperless-AI verarbeitet nur Dokumente, die dieser Benutzer ändern darf. So steuerst du auch, welche Dokumente die KI gar nicht erst zu sehen bekommt.
2. Container starten
Paperless-AI läuft dort, wo auch Paperless-ngx läuft, zum Beispiel auf dem NAS. Lege ein neues Projekt mit dieser Compose-Datei an:
services:
  paperless-ai:
    image: clusterzx/paperless-ai:latest
    container_name: paperless-ai
    restart: unless-stopped
    ports:
      - "3000:3000"
    volumes:
      - /volume1/docker/paperless-ai:/app/data
docker compose up -d
docker compose logs -f paperless-aiDas Image gibt es für Intel- und ARM-Prozessoren. Wer die OCR auf einer NVIDIA-Grafikkarte rechnen lassen will, nimmt die Variante mit dem Zusatz cuda.
3. Einrichtungsassistent durchlaufen
Öffne http://192.168.10.20:3000 im Browser. Der Assistent fragt nacheinander das Konto, die Verbindung zu Paperless-ngx, den KI-Anbieter und die Verarbeitung ab. Als Adresse von Paperless-ngx trägst du http://192.168.10.20:8000 ein, dazu das Token aus Schritt 1.
Erledige die Einrichtung sofort nach dem Start. Solange noch kein Konto existiert, steht der Assistent jedem offen, der die Adresse erreicht. Schalte danach in den Einstellungen die Zwei-Faktor-Authentifizierung ein.
4. Testlauf mit Trigger-Tag
Lass die KI nicht gleich auf das ganze Archiv los. Stelle zuerst ein, dass nur Dokumente mit einem bestimmten Tag verarbeitet werden, und gib diesen Tag zehn Testdokumenten. Sieh dir die Ergebnisse in der manuellen Prüfung an. Erst wenn Titel und Zuordnung passen, gibst du die automatische Verarbeitung frei. Sinnvoll ist außerdem, die KI auf vorhandene Tags und Dokumenttypen zu beschränken. Sonst erfindet sie mit der Zeit Dutzende ähnlicher Schlagworte.
Variante 1: OpenAI-API
Gemeint ist nicht das Abo von ChatGPT, sondern der Zugang für Entwickler. Beides wird getrennt abgerechnet.
- Lege auf der Plattform von OpenAI ein Konto an, hinterlege ein Guthaben und erzeuge einen API-Schlüssel.
- Wähle in Paperless-AI unter KI-Anbieter den Eintrag OpenAI.
- Trage den Schlüssel und das Modell ein. Für die Verschlagwortung genügt ein kleines, günstiges Modell. Die Vorlage des Projekts nennt als Beispiel gpt-5-mini.
Wer die Einstellungen lieber fest in der Compose-Datei hinterlegt, ergänzt diesen Block. Werte aus der Umgebung haben Vorrang und erscheinen in der Oberfläche als gesperrt:
    environment:
      - AI_PROVIDER=openai
      - OPENAI_API_KEY=DEIN-OPENAI-SCHLUESSEL
      - OPENAI_MODEL=gpt-5-mini
Setze beim Anbieter ein monatliches Ausgabenlimit. Eine falsch eingestellte Verarbeitung, die das ganze Archiv mehrfach durchläuft, bleibt so ein kleines Ärgernis.
Variante 2: Claude über die Anthropic-API
Für Claude gibt es zwei Möglichkeiten. Die erste ist die bessere.
Nativer Anthropic-Provider
Paperless-AI 4 spricht die Schnittstelle von Anthropic von Haus aus. Du erzeugst in der Claude Console einen API-Schlüssel, wählst in Paperless-AI den Anbieter Anthropic und trägst Schlüssel und Modell ein. Für die Verschlagwortung reicht das kleine, schnelle Modell Claude Haiku 5.5. Für schwierige Dokumente oder Fragen an das Archiv lohnt sich Claude Sonnet 5.5.
    environment:
      - AI_PROVIDER=anthropic
      - ANTHROPIC_API_KEY=DEIN-ANTHROPIC-SCHLUESSEL
      - ANTHROPIC_MODEL=claude-haiku-5-5
OpenAI-kompatibler Endpoint
Anthropic bietet zusätzlich eine Schnittstelle im OpenAI-Format an. Damit lässt sich Claude in jede Software einbinden, die nur OpenAI kennt. In Paperless-AI wählst du dafür den Anbieter OpenAI-kompatibel und trägst die Adresse von Anthropic ein:
    environment:
      - AI_PROVIDER=custom
      - CUSTOM_BASE_URL=https://api.anthropic.com/v1/
      - CUSTOM_API_KEY=DEIN-ANTHROPIC-SCHLUESSEL
      - CUSTOM_MODEL=claude-haiku-5-5
Das funktioniert, hat aber Grenzen, die Anthropic selbst nennt. Die Schnittstelle ist zum Testen und Vergleichen gedacht und gilt nicht als Dauerlösung. Einige Funktionen fehlen, etwa das Prompt Caching. Und bei den aktuellen Modellen führt eine abweichende Einstellung der Temperatur zu einer Fehlermeldung. Weil Paperless-AI den direkten Weg beherrscht, nimm diesen. Der Umweg über das OpenAI-Format lohnt sich nur, wenn du Claude über ein Gateway beziehst, das ausschließlich dieses Format anbietet.
Variante 3: Lokale Inferenz auf der NVIDIA DGX Spark

Die DGX Spark ist ein handlicher KI-Rechner mit 128 GB Speicher, den sich Prozessor und Grafikeinheit teilen. Bei rund 240 Watt läuft sie leise im Dauerbetrieb. Ihre Stärke passt genau zu Paperless-AI: viel Text hinein, wenig Text heraus. In unserem Praxistest der DGX Spark haben wir für genau dieses Profil niedrige Antwortzeiten und einen guten Gesamtdurchsatz gemessen.
Als Modell nutzen wir Qwen3.8-27B von Alibaba. Es steht unter der freien Lizenz Apache 2.0, darf also auch im Betrieb ohne Gebühren eingesetzt werden, und liefert bei deutschen Dokumenten sehr brauchbare Ergebnisse. Mehr dazu steht in unserem Beitrag Qwen3.8-27B im Überblick.
Modell mit vLLM bereitstellen
Auf der DGX Spark stellt ein Inferenzserver das Modell im Netz bereit. Wir verwenden vLLM, das eine Schnittstelle im OpenAI-Format mitbringt:
vllm serve Qwen/Qwen3.8-27B \
  --served-model-name qwen3.8-27b \
  --host 0.0.0.0 --port 8000 \
  --api-key DEIN-INTERNER-SCHLUESSEL
Den genauen Namen der gewünschten Modellvariante übernimmst du von der Modellseite. Quantisierte Fassungen brauchen weniger Speicher und laufen schneller.
Paperless-AI an vLLM anbinden
In Paperless-AI wählst du den Anbieter OpenAI-kompatibel und trägst die Adresse der DGX Spark ein. Im Beispiel hat sie die Adresse 192.168.10.30:
    environment:
      - AI_PROVIDER=custom
      - CUSTOM_BASE_URL=http://192.168.10.30:8000/v1
      - CUSTOM_API_KEY=DEIN-INTERNER-SCHLUESSEL
      - CUSTOM_MODEL=qwen3.8-27b
      - CUSTOM_EXTRA_BODY={"chat_template_kwargs": {"enable_thinking": false}}
Die letzte Zeile schaltet das ausführliche Nachdenken des Modells ab. Für das Auslesen von Metadaten bringt es keinen Vorteil, kostet aber viel Zeit. Das Projekt empfiehlt diese Einstellung ausdrücklich.
Alternative: Ollama
Wer es einfacher mag, nimmt Ollama. Paperless-AI kennt dafür einen eigenen Anbieter. Die Vorlage des Projekts nennt als kleines Beispielmodell qwen3:8b:
    environment:
      - AI_PROVIDER=ollama
      - OLLAMA_API_URL=http://192.168.10.30:11434
      - OLLAMA_MODEL=qwen3:8b
      - OLLAMA_THINK=off
      - OLLAMA_NUM_CTX=16384
Paperless-AI arbeitet mit einer festen Kontextgröße von 16.384 Token, damit Ollama das Modell zwischen zwei Dokumenten nicht neu lädt. Längere Dokumente werden passend gekürzt. Hat deine Hardware Reserven, kannst du den Wert erhöhen.
Lokale Embeddings für die Archivsuche
Für die Funktion Frag dein Archiv braucht Paperless-AI zusätzlich ein Embedding-Modell. Ab Werk ist ein kleines, mehrsprachiges Modell eingebaut, das auf dem Prozessor des Containers läuft. Zusammen mit einem lokalen Sprachmodell bleibt damit die gesamte Kette im Haus: OCR, Auswertung, Suche und Antwort.
Hardware für lokale Inferenz
Aufbau A: NAS plus DGX Spark
Das ist unser Aufbau. Das Archiv und Paperless-AI laufen auf einem NAS mit RAID, das Sprachmodell auf der DGX Spark. Beide Geräte tun, was sie am besten können, und die DGX Spark steht nebenbei für weitere KI-Aufgaben bereit. Als NAS reicht ein Gerät wie das UGREEN DXP4800 Pro aus unserer Paperless-Anleitung.
NVIDIA DGX Spark (128 GB)
Preis & Verfügbarkeit auf Amazon prüfen. Als Amazon-Partner verdienen wir an qualifizierten Käufen. Für dich entstehen dadurch keine Mehrkosten.
Aufbau B: All-in-one mit dem UGREEN iDX6011 Pro
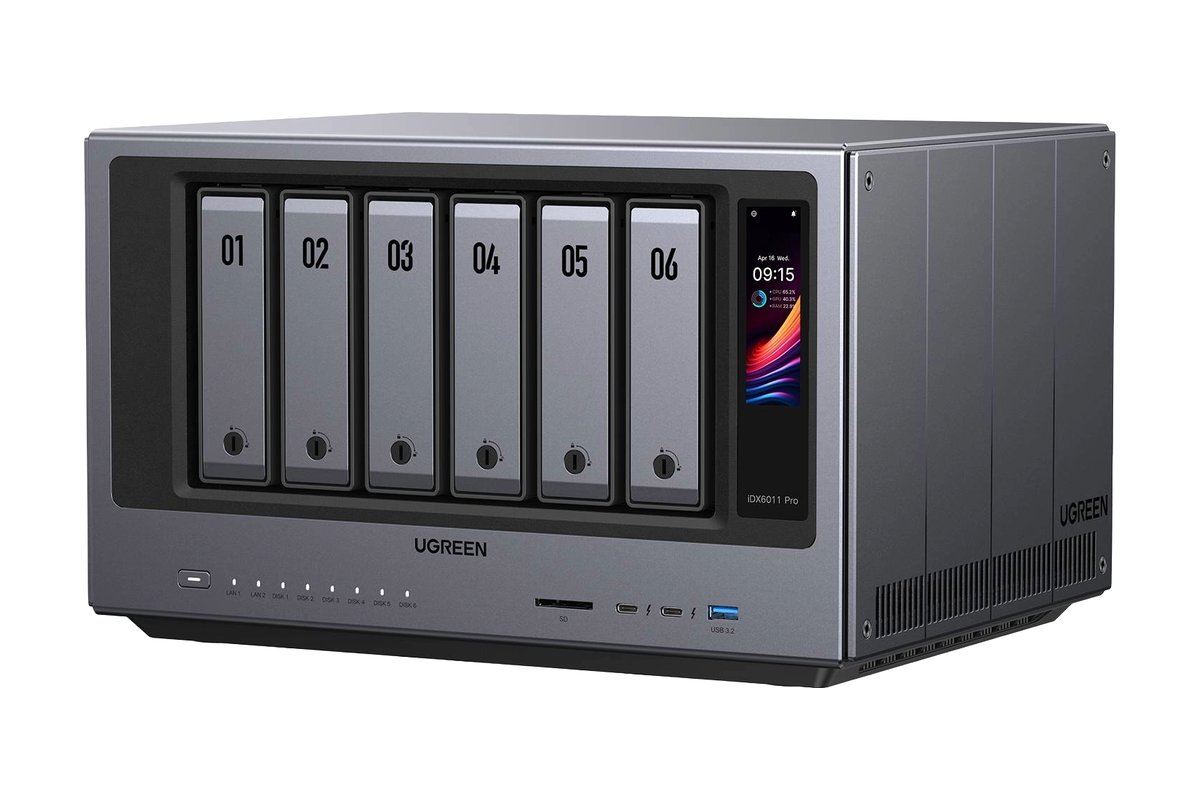
Wer nur ein Gerät aufstellen will, greift zu einem NAS, das selbst genug Leistung für Sprachmodelle hat. Das UGREEN iDX6011 Pro ist dafür gebaut: sechs Einschübe für das RAID, ein Prozessor mit eigener KI-Einheit und 64 GB Arbeitsspeicher. Darauf laufen Paperless-ngx, Paperless-AI und per Docker auch ein Inferenzserver wie Ollama mit einem Modell wie Qwen3.8-27B. Speicher, Archiv und KI stehen dann in einem Gehäuse.
| Merkmal | UGREEN iDX6011 Pro | NVIDIA DGX Spark |
|---|---|---|
| Aufgabe | NAS und KI in einem | reiner KI-Rechner |
| Prozessor | Intel Core Ultra 7, 16 Kerne | NVIDIA GB10, 20 ARM-Kerne |
| Speicher für Modelle | 64 GB, fest verbaut | 128 GB, gemeinsam genutzt |
| Festplatten | 6 Einschübe, 2 x M.2 | eine interne SSD |
| Netzwerk | 2 x 10 Gigabit | 10 Gigabit, 2 x QSFP |
| Software | UGOS Pro mit Docker | Linux mit CUDA |
| Preis | rund 4.800 Euro ohne Platten | rund 3.000 bis 6.000 Euro |
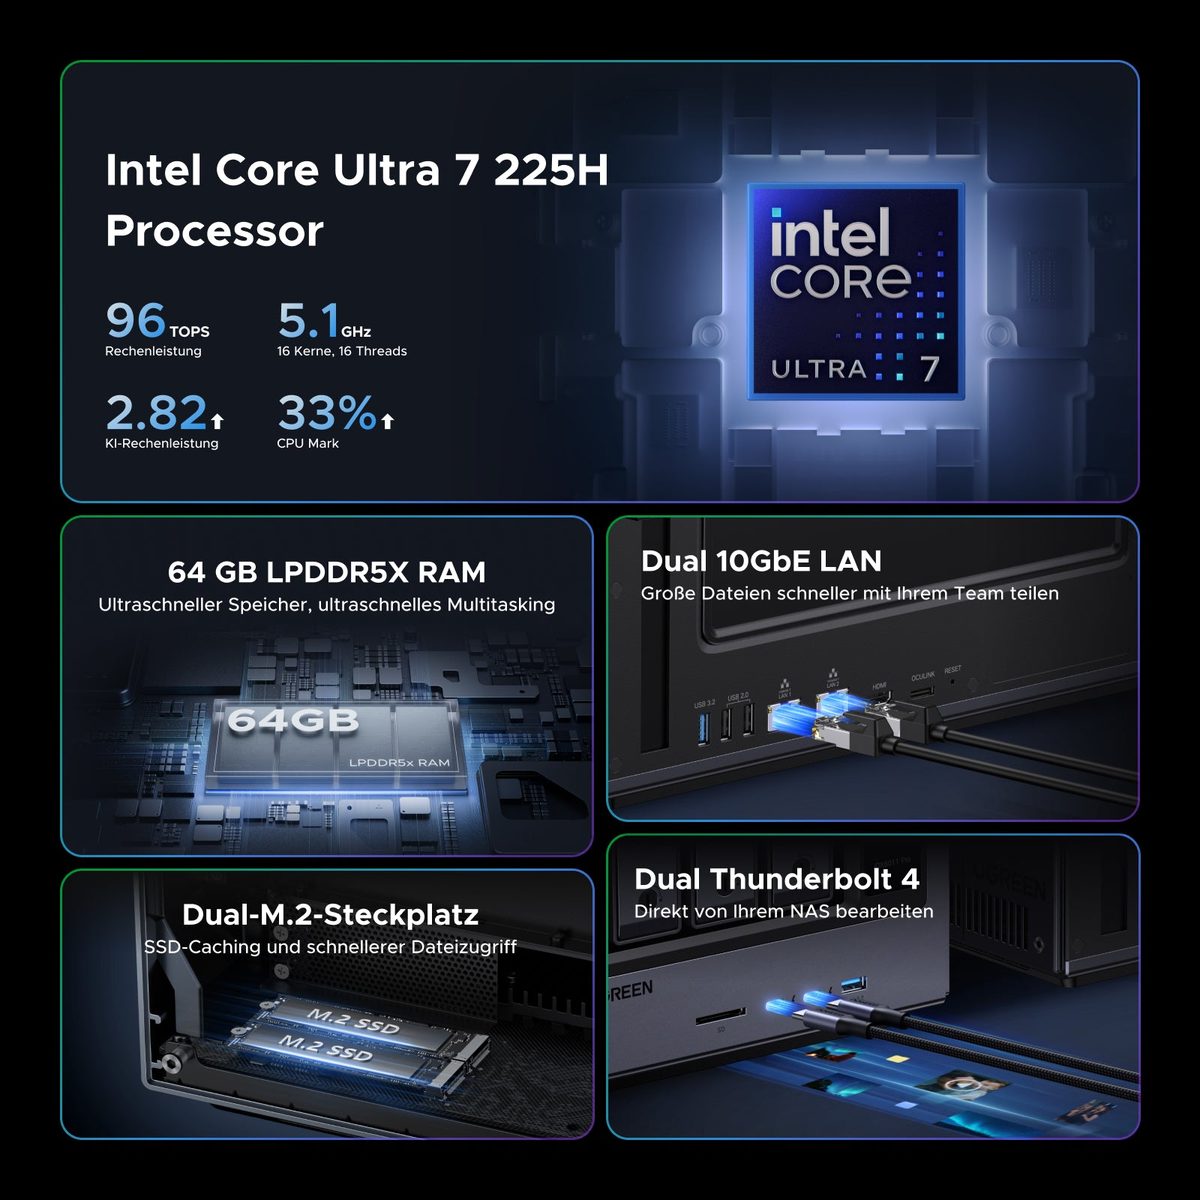
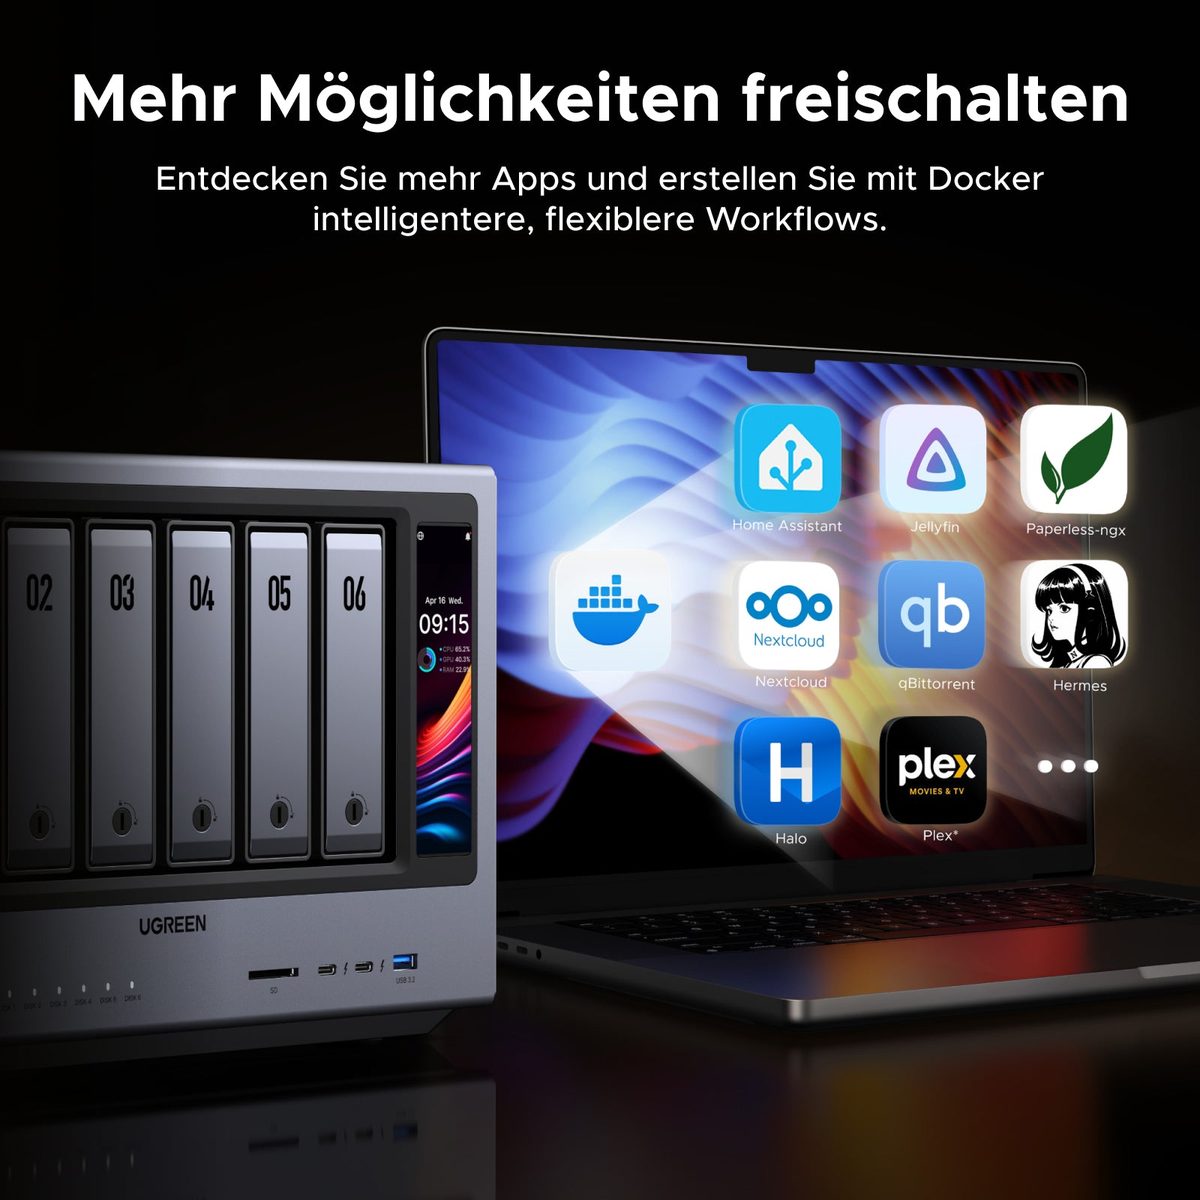
Zur Einordnung: Ein Modell mit 27 Milliarden Parametern belegt in 4-Bit-Quantisierung rund 15 GB und passt damit bequem in die 64 GB des iDX6011 Pro. Die DGX Spark rechnet mit ihrer NVIDIA-Grafikeinheit allerdings deutlich schneller und hat doppelt so viel Speicher für größere Modelle und lange Dokumente. Für ein Archiv, das neue Dokumente nach und nach verarbeitet, kommt es auf Sekunden nicht an. Wer dagegen viele Nutzer, große Modelle oder weitere KI-Projekte plant, ist mit der getrennten Lösung besser bedient.
UGREEN iDX6011 Pro, KI-NAS mit 6 Einschüben
Preis & Verfügbarkeit auf Amazon prüfen. Als Amazon-Partner verdienen wir an qualifizierten Käufen. Für dich entstehen dadurch keine Mehrkosten.
Betriebsparameter und Optimierung
Workflow-Webhook statt Polling
Ab Werk sieht Paperless-AI alle 30 Minuten nach neuen Dokumenten. Schneller geht es mit einem Workflow in Paperless-ngx, der Paperless-AI bei jedem neuen Dokument anstößt:
- In Paperless-ngx unter Workflows einen neuen Workflow mit dem Trigger Dokument hinzugefügt anlegen.
- Als Aktion Webhook wählen, mit der Adresse
http://192.168.10.20:3000/api/webhook/documentund dem Parameter url mit dem Wert {doc_url}. - Als Header x-api-key den Schlüssel aus den Einstellungen von Paperless-AI eintragen.
Exclude-Tags
Mit Exclude-Tags nimmst du Dokumente von der automatischen Verarbeitung aus. Das ist auch beim Cloud-Betrieb nützlich: Dokumente mit dem Tag Vertraulich gehen dann gar nicht erst an den Anbieter.
OCR mit PaddleOCR
Die eingebaute OCR liest Scans ohne Text oder mit schlechtem Text neu ein. Sie ersetzt den Text in Paperless-ngx nur, wenn das Ergebnis besser ist als der vorhandene Text. Empfohlen ist die Einstellung, die nur Dokumente ohne oder mit schlechtem Text anfasst.
Prompt-Regeln je Dokumentart
Seit Version 4.4 kannst du je Dokumentart einen eigenen Prompt hinterlegen. Rechnungen bekommen dann Rechnungsnummer und Betrag als eigene Felder, während Unterrichtsmaterial Fach und Klassenstufe erhält und keinen Korrespondenten. Die erste passende Regel gewinnt, alle anderen Dokumente laufen wie bisher.
Sicherheit im Betrieb
- Stelle Paperless-AI nicht ins Internet. Greife von unterwegs über ein VPN zu.
- Schalte die Zwei-Faktor-Authentifizierung ein oder nutze Single Sign-on.
- Gib dem Benutzer von Paperless-AI in Paperless-ngx nur die Rechte, die er braucht.
- Sichere das Datenverzeichnis von Paperless-AI mit. Darin liegen Einstellungen, Verlauf und Suchindex.
- Schütze den Inferenzserver mit einem Schlüssel und erlaube den Zugriff nur aus dem eigenen Netz.
- Prüfe die Ergebnisse der KI in den ersten Wochen regelmäßig. Auch gute Modelle ordnen gelegentlich falsch zu.
Lokale KI für dein Dokumentenarchiv
Wir betreiben Paperless-ngx und Paperless-AI selbst mit einem lokalen Sprachmodell und richten denselben Aufbau für Betriebe ein: NAS mit RAID, Archiv, KI-Hardware, Sicherung und Zugriff per VPN. Auf Wunsch betreuen wir das System im laufenden Betrieb.
Beratung anfragen DGX Spark im PraxistestFazit
Paperless-AI 4 macht aus einem gut sortierten Archiv eines, das sich selbst sortiert. Die Neuentwicklung ist schlanker, sicherer und deutlich bequemer zu bedienen als die Vorgänger. Für den schnellen Einstieg genügt ein API-Schlüssel von OpenAI oder Anthropic. Wer vertrauliche Unterlagen verarbeitet, sollte den Schritt zum lokalen Modell gehen. Mit einer DGX Spark neben dem NAS oder einem KI-NAS wie dem UGREEN iDX6011 Pro bleibt jedes Dokument im Haus, und die laufenden Kosten beschränken sich auf den Strom.
Wir nutzen diesen Aufbau selbst jeden Tag. Wenn du ihn für deinen Betrieb haben möchtest, melde dich bei uns.
Häufige Fragen
Was ist der Unterschied zwischen Paperless-ngx und Paperless-AI?
Paperless-ngx ist das Dokumentenarchiv mit OCR und Suche. Paperless-AI ist ein Zusatz, der neue Dokumente von einem Sprachmodell auswerten lässt und Titel, Tags, Korrespondent, Dokumenttyp und Datum automatisch einträgt.
Welche KI-Anbieter unterstützt Paperless-AI 4?
OpenAI, Anthropic mit Claude, Ollama, Azure OpenAI und jede Schnittstelle im OpenAI-Format, zum Beispiel vLLM, LM Studio oder OpenRouter. Der Anbieter lässt sich in der Weboberfläche jederzeit wechseln.
Kann ich Claude über die OpenAI-kompatible Schnittstelle anbinden?
Ja, mit der Adresse https://api.anthropic.com/v1/ und einem API-Schlüssel von Anthropic. Anthropic sieht diese Schnittstelle aber zum Testen vor, einige Funktionen fehlen. Paperless-AI 4 kann Claude direkt ansprechen, das ist der bessere Weg.
Verlassen meine Dokumente bei einem lokalen Sprachmodell das Haus?
Nein. Läuft das Modell auf eigener Hardware wie der DGX Spark oder einem KI-NAS, wandert der Text nur innerhalb des eigenen Netzes. Auch die Suche im Archiv arbeitet mit einem eingebauten lokalen Modell.
Ist der Betrieb mit lokalem Modell automatisch DSGVO-konform?
Die Übermittlung an einen externen KI-Anbieter entfällt, und damit der schwierigste Teil. Zugriffsrechte, Löschfristen, Datensicherung und Dokumentation musst du trotzdem regeln. Sprich im Betrieb mit deinem Datenschutzbeauftragten.
Welche Hardware brauche ich für ein lokales Sprachmodell?
Für ein Modell mit 27 Milliarden Parametern in 4-Bit-Quantisierung rund 15 GB freien Arbeits- oder Grafikspeicher. Wir nutzen eine NVIDIA DGX Spark mit 128 GB. Als Gerät für alles eignet sich ein KI-NAS wie das UGREEN iDX6011 Pro mit 64 GB.
Muss ich von Paperless-AI 3 auf Version 4 wechseln?
Ja. Die Versionen vor 4.0 haben eine Sicherheitslücke im Einrichtungsassistenten, die laut Projekt bereits ausgenutzt wird. Einstellungen, Konto und Verlauf werden beim ersten Start von Version 4 automatisch übernommen.
Was kostet die Verarbeitung über OpenAI oder Claude?
Abgerechnet wird nach verarbeitetem Text. Mit einem kleinen Modell liegen die Kosten je Dokument im Bereich von Bruchteilen eines Cents bis wenigen Cent. Setze beim Anbieter trotzdem ein monatliches Ausgabenlimit.
Quellen
- Paperless-AI: Projektseite und README auf GitHub, Stand Version 4.4.0
- Paperless-AI: Versionshinweise 4.0.0 bis 4.4.0, 10. bis 20. November 2026
- Anthropic: Dokumentation zur OpenAI-kompatiblen Schnittstelle der Claude API
- UGREEN: Produktseite iDX6011 Pro 6-Bay AI NAS
- K&C NetFox: NVIDIA DGX Spark im Test, eigene Messwerte
- K&C NetFox: Qwen3.8-27B im Überblick
Bildschirmfotos: Paperless-AI-Projekt (MIT-Lizenz). Produktfotos und Grafiken: UGREEN. Foto DGX Spark: K&C NetFox.